王本友:为什么我们要专门训练一个牙科大模型
过去三年,我一直在参与医疗大模型的研究:从 HuatuoGPT、HuatuoGPT-II,到能看懂医学影像的 HuatuoGPT-Vision,再到会做复杂医学推理的 HuatuoGPT-o1。这两年转向口腔,被问得最多的一个问题是:通用大模型越来越强,为什么还要专门训练一个牙科大模型?
我的回答是:在牙科,“通用”还不够用。下面我不讲观点,只讲我们自己论文里的数据。
一、牙科在通用数据里几乎是“盲区”
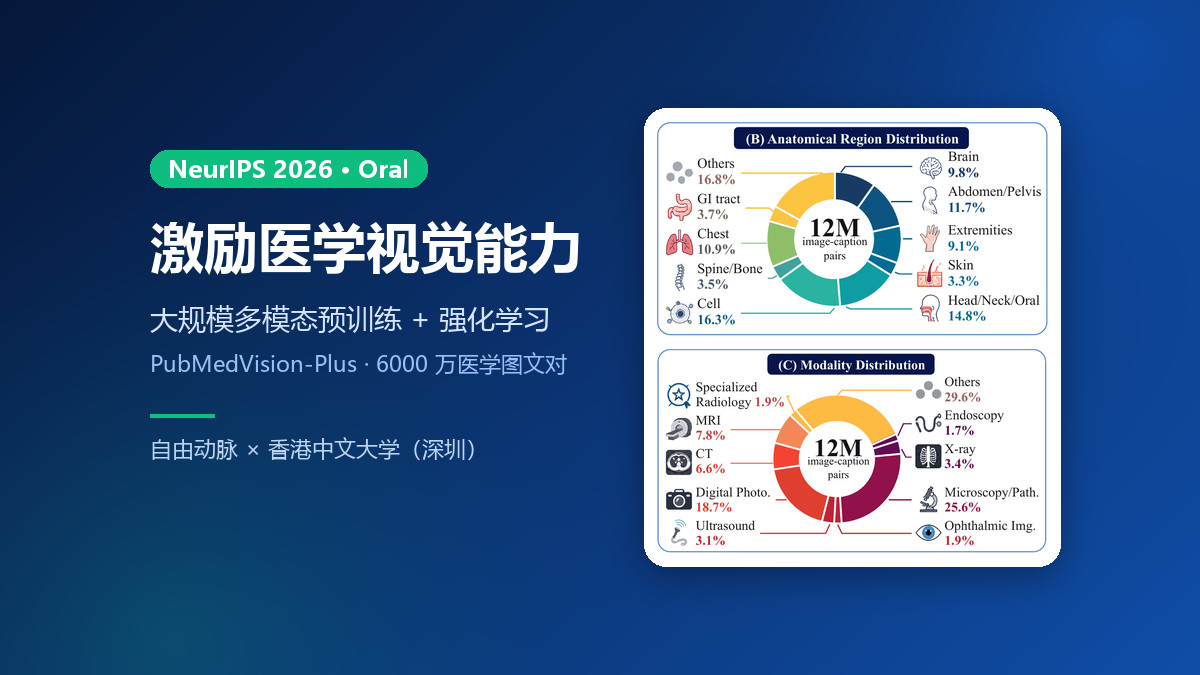
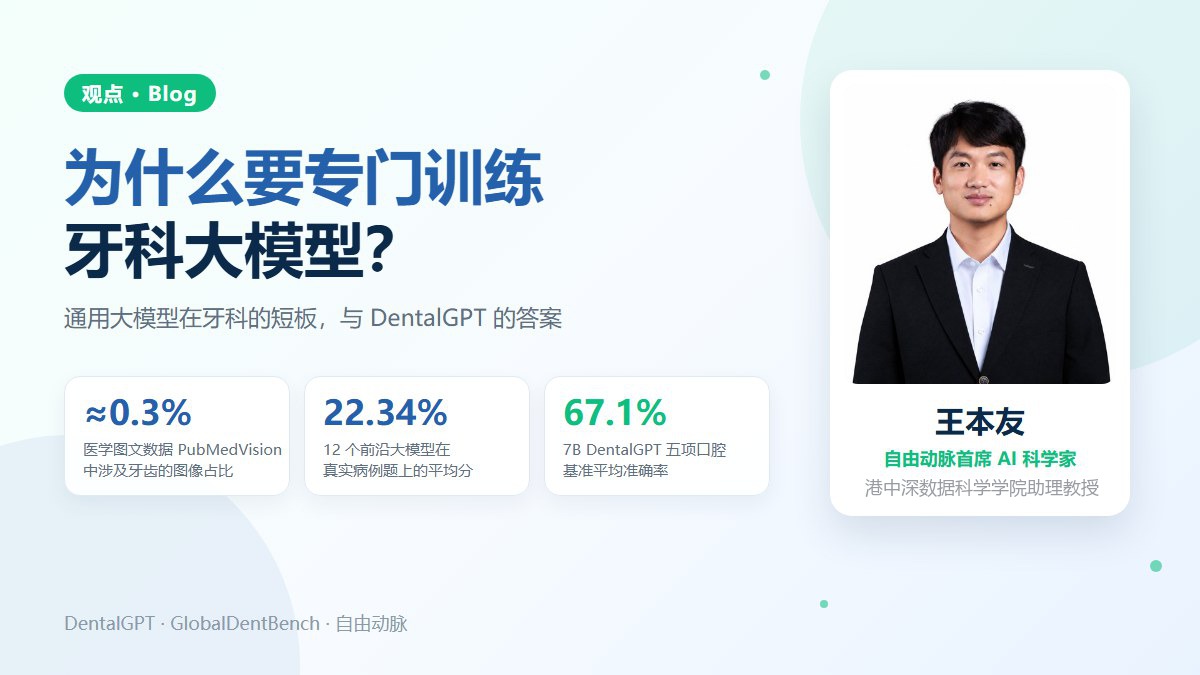
大模型的能力来自数据。可牙科在通用数据里占的比例非常小:我们在 DentalGPT 的预印本里统计过,规模很大的医学图文数据集 PubMedVision 中,涉及牙齿的图像只占约 0.3%。
牙科影像又恰恰很“细”。一张全景片要呈现整副牙列,充填体、根管治疗、阻生齿、根尖病变往往只占很小一块区域;口内照片、根尖片、头颅侧位片、CBCT 各有各的读法。模型没怎么见过这些图,自然谈不上读懂。
二、通用模型“看得见”,却“数不对、判不准”
在全景片问答基准 MMOral-OPG-Bench 上,GPT-5、Gemini-2.5-Pro、Claude-Sonnet-4.5 这些头部模型的准确率都没有超过 60%。我们还发现,即便打开“思考模式”,它们在口腔任务上的提升也明显小于其他医学领域。
DentalGPT 论文里有一个很直观的例子:让模型数出一张全景片上有充填体的牙齿,正确答案是 10 颗。GPT-5 给出约 6 颗,Qwen3-VL-235B 的非思考版本数出 16 颗,思考版本反复自我检查后停在 8 颗。模型能找到相关的视觉线索,却没能据此得出正确答案。问题不只是“没看见”,而是缺少把视觉细节和牙科知识对上的能力。
三、越接近真实病例,模型越吃力
为了看清这些短板,我们和全球的牙科专家一起建设了评测基准 GlobalDentBench:8,978 道经专家验证的问题,题目来源覆盖 88 个国家和地区、14 个牙科专科。在 12 个前沿大模型上,结果很清楚:
- 题目越像真实临床,得分越低:选择题平均 81.34%,简答题 64.53%,来自真实病例报告的病例题只有 22.34%。
- 越需要个体化判断,越吃力:平均得分从“知识回忆”的 74.01%,降到“常规推理”的 55.64%,再降到“个体化推理”的 35.71%;所有模型在个体化推理上都低于 50%。
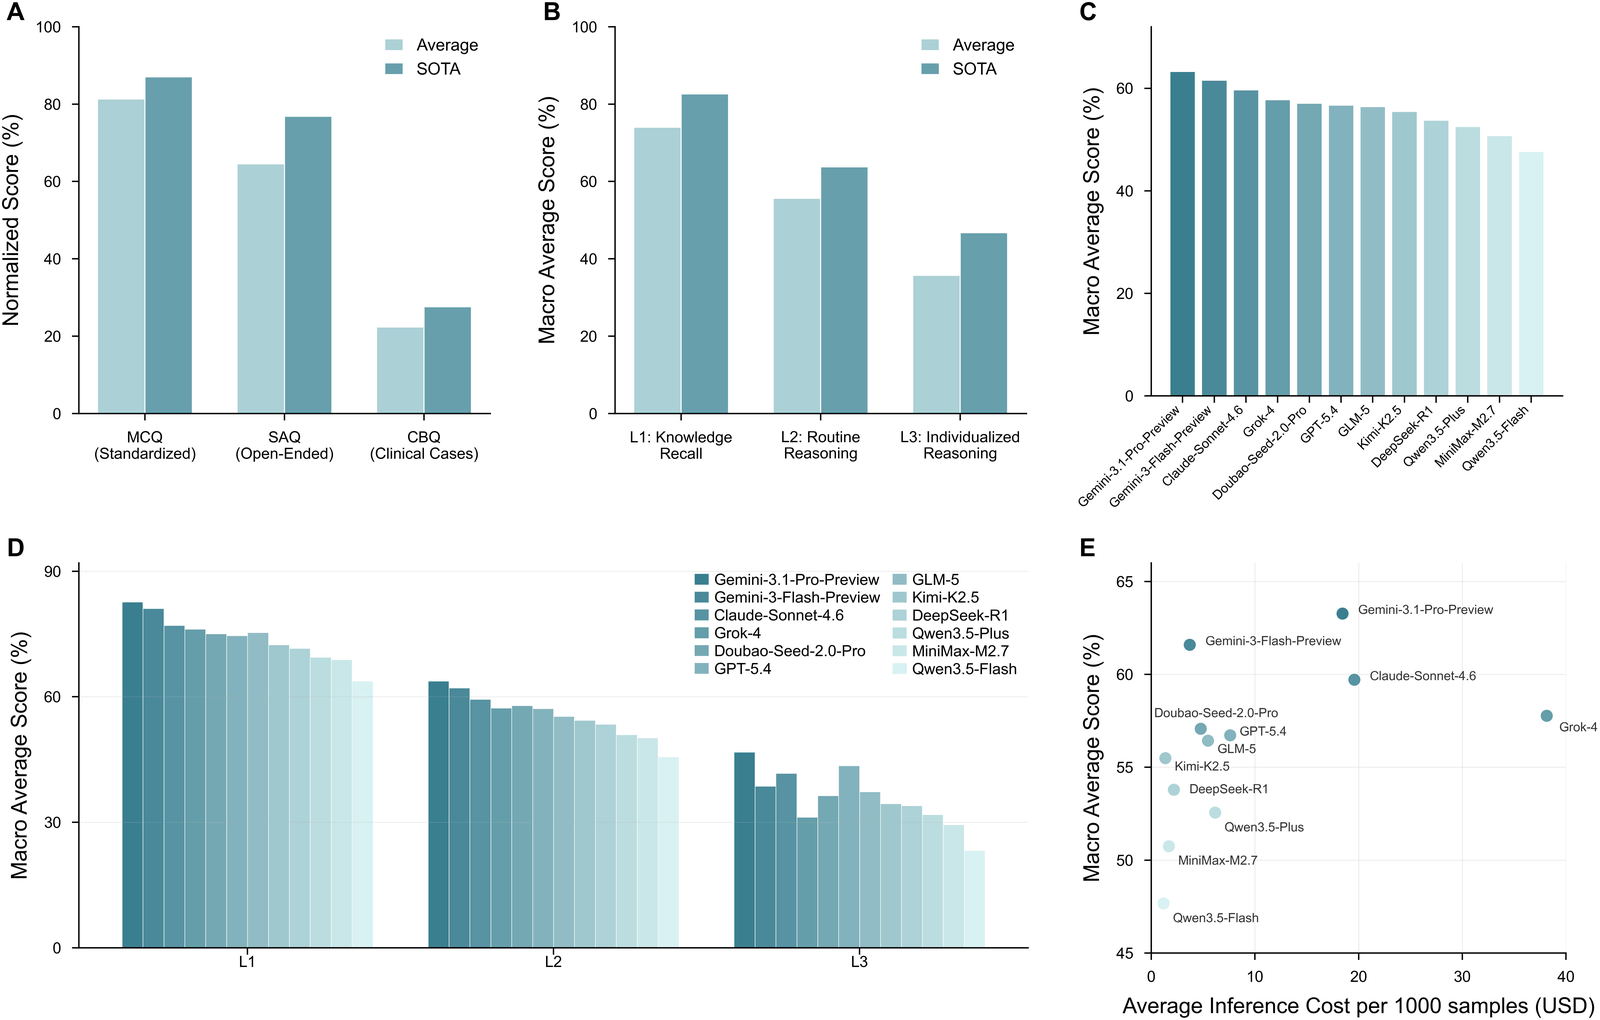 图 1:12 个前沿大模型在 GlobalDentBench 上的结果:题型、推理层级、综合排名与推理成本(图源:GlobalDentBench 论文)
换句话说,今天的大模型更像一个背熟了教材的学生,还不是一个能结合具体病人做决定的医生。
四、在牙科,有些错误是不可逆的
我最在意的是安全。GlobalDentBench 对 1,590 道病例题的 19,080 条回答做了风险评估:31.01% 被判为不安全,其中 4.51% 可能造成不可逆伤害;口腔正畸的不安全比例最高,达到 44.30%。
牙齿不会再长。我们的使命是“让每个人拥有一口原生牙齿,健康活到120岁”,一次不必要的拔牙、一次过度的治疗建议,代价就是永久的。这也是为什么我们认为,现阶段的大模型适合在专家监督下辅助检索和整理知识,还不能独立承担牙科临床决策。
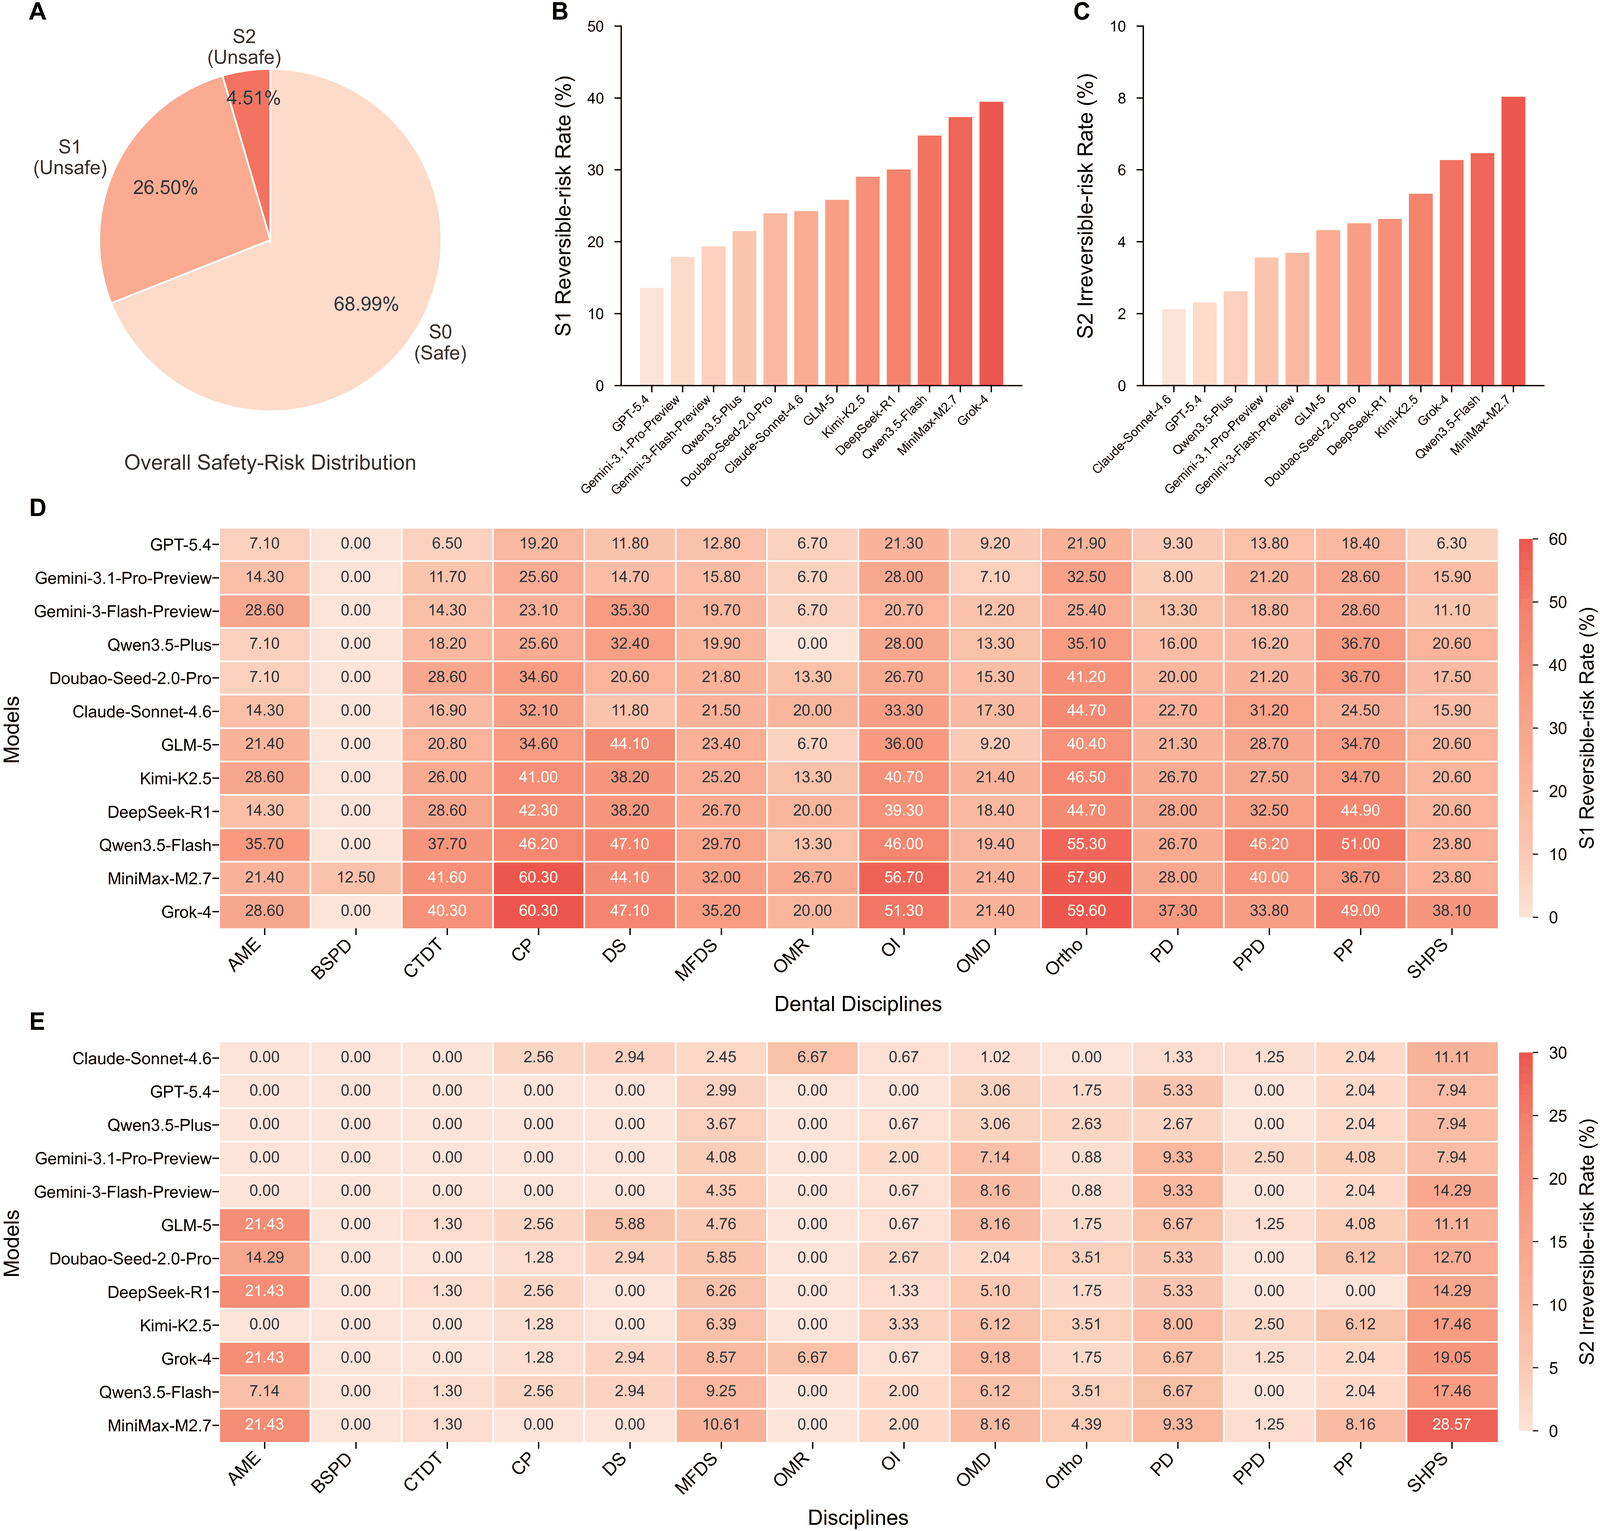 图 2:病例题回答的安全风险分析,S1 为可能造成可逆伤害,S2 为可能造成不可逆伤害(图源:GlobalDentBench 论文)
五、专科模型可以又小又强
好消息是,专门训练是有效的。DentalGPT 只有 7B 参数:我们先用 12 万余张牙科图像做多模态对齐,让模型学会“看”;再用强化学习激发复杂推理,让它学会“想”。在五项口腔基准上,它的平均准确率达到 67.1%,高于 GPT-5 的 59.2%;在全景片分类上达到 84.0%,基座模型和 GPT-5 分别为 50.0% 和 63.5%。回到数充填体的例子,训练后的 DentalGPT 经过反复核对,最终数对了 10 颗。
消融实验也说明了顺序的重要:只做多模态对齐,平均准确率从 46.7% 升到 63.2%;再加强化学习升到 67.1%。没有经过牙科对齐的模型,强化学习带来的提升很有限,对齐数据越多,强化学习能达到的上限越高。专科知识是推理的地基,而不是可有可无的点缀。
在 4 位执业牙医的盲评中,DentalGPT 与 GPT-5、Gemini-2.5-Pro 相比以平局居多,胜多负少;对比 Claude-Sonnet-4.5 和 Qwen3-VL-235B,胜率分别达到 63.9% 和 87.5%。
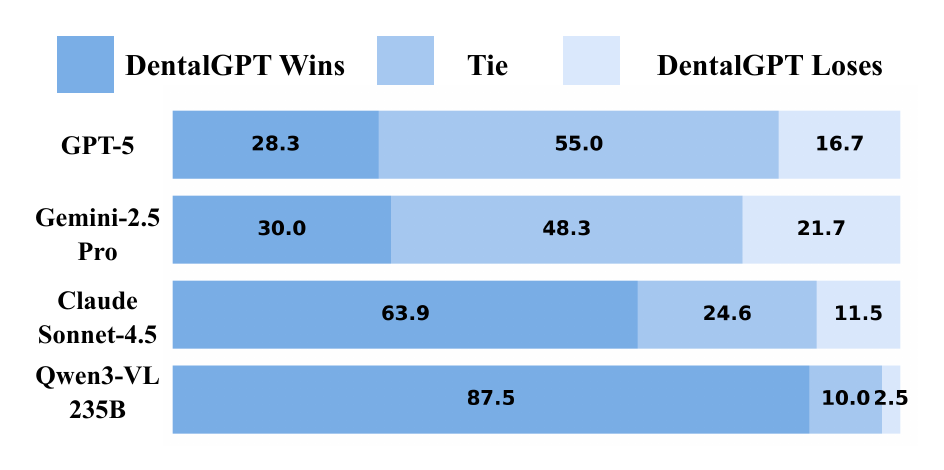 图 3:执业牙医两两对比评估,DentalGPT 胜、平、负的比例(%)(图源:DentalGPT 论文)
六、专科模型不是闭门造车
训练牙科大模型,难点从来不只在算法:
- 专家要深度参与。GlobalDentBench 的构建由 6 位持证资深牙医全程把关,投入 297 人·小时;DentalGPT 的专家标注数据里,交叉验证一致率低于 85% 的标注会被直接过滤。
- 评测要跨国家、跨标准。各国的诊疗规范和执业考试并不相同,所以我们从一开始就做多国评测;正在建设的 OmniDentBench 会从真实病例报告中筛选高难度题目,由国内外牙科专家逐题评审,专门检验专家级的临床决策。
- 模型要会用工具、讲依据。我们在做的 DentalAgent,让模型调用牙位识别、病变分类、测量等专业工具,检索教材、指南和病例作为证据,输出可以核验的判断。
- 医生始终做最终决定。在与南方医科大学深圳口腔医院(坪山)、佛山市口腔医院的合作中,AI 给出建议、列出证据、提示缺口,诊断和治疗的判断权始终留在医生手里。
写在最后
我们做 DentalGPT,不是要做一个“替代牙医”的模型,而是希望专业的口腔判断能来得更早、覆盖更多的人:在问题还小的时候发现它,在牙齿还能保住的时候保住它。通用大模型会继续进步,但在一个高度专业、错误代价不可逆的领域,专门的数据、专门的训练、专门的评测,和医生一起,缺一不可。
参考论文
- DentalGPT: Incentivizing Multimodal Reasoning in Dentistry,Findings of ACL 2026:https://aclanthology.org/2026.findings-acl.135/
- GlobalDentBench: A Multinational Benchmark for Evaluating LLM Clinical Reasoning in Dentistry with Expert Calibration,npj Digital Medicine(已录用);预印本:https://arxiv.org/abs/2605.24636
- Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems(HuatuoGPT-o1),Findings of ACL 2025:https://aclanthology.org/2025.findings-acl.751/
- 更多介绍:DentalGPT 与核心技术、牙科评测:GlobalDentBench 与 OmniDentBench