
自由动脉核心技术 · Findings of ACL 2026
DentalGPT
口腔多模态大模型
以 12 万余张牙科图像做多模态对齐,再用强化学习激发复杂推理:7B 参数的 DentalGPT 在五项口腔基准上平均准确率 67.1%,超过 GPT-5 的 59.2%。
7B参数规模
12 万+张标注牙科图像
67.1%五项口腔基准平均准确率
84.0%全景片分类准确率
4位执业牙医参与评估
模型:先学会“看”,再学会“想”
口腔 AI 有四个难点,DentalGPT 逐一应对。 延伸阅读:王本友《为什么我们要专门训练一个牙科大模型》→
01
牙科数据稀缺
大规模医学图文数据集 PubMedVision 中,涉及牙齿的图像只占约 0.3%。
DentalGPT 的做法汇集 12 万余张口内照片和全景片构建专科数据集;专家标注交叉验证一致率低于 85% 的直接过滤。
02
影像细节难读
充填体、根管治疗、根尖病变往往只占全景片的一小块;头部通用模型在全景片问答基准上的准确率都不到 60%。
DentalGPT 的做法第一阶段多模态对齐:生成只描述可见特征的观察式描述,让模型把视觉细节和牙科概念对上。
03
临床推理复杂
越接近真实病例越难:12 个前沿模型在需要结合患者个体情况的推理题上,平均只有 35.71%。
DentalGPT 的做法第二阶段强化学习:用约 1 万道可自动判分的题目做 GRPO 训练,激发多步推理。
04
安全要求高
前沿模型对真实病例的回答中,31.01% 被判为不安全,4.51% 可能造成不可逆伤害。
DentalGPT 的做法跨国、专家级评测持续检验模型;DentalAgent 给出可核验的证据,诊疗决定始终由医生做出。
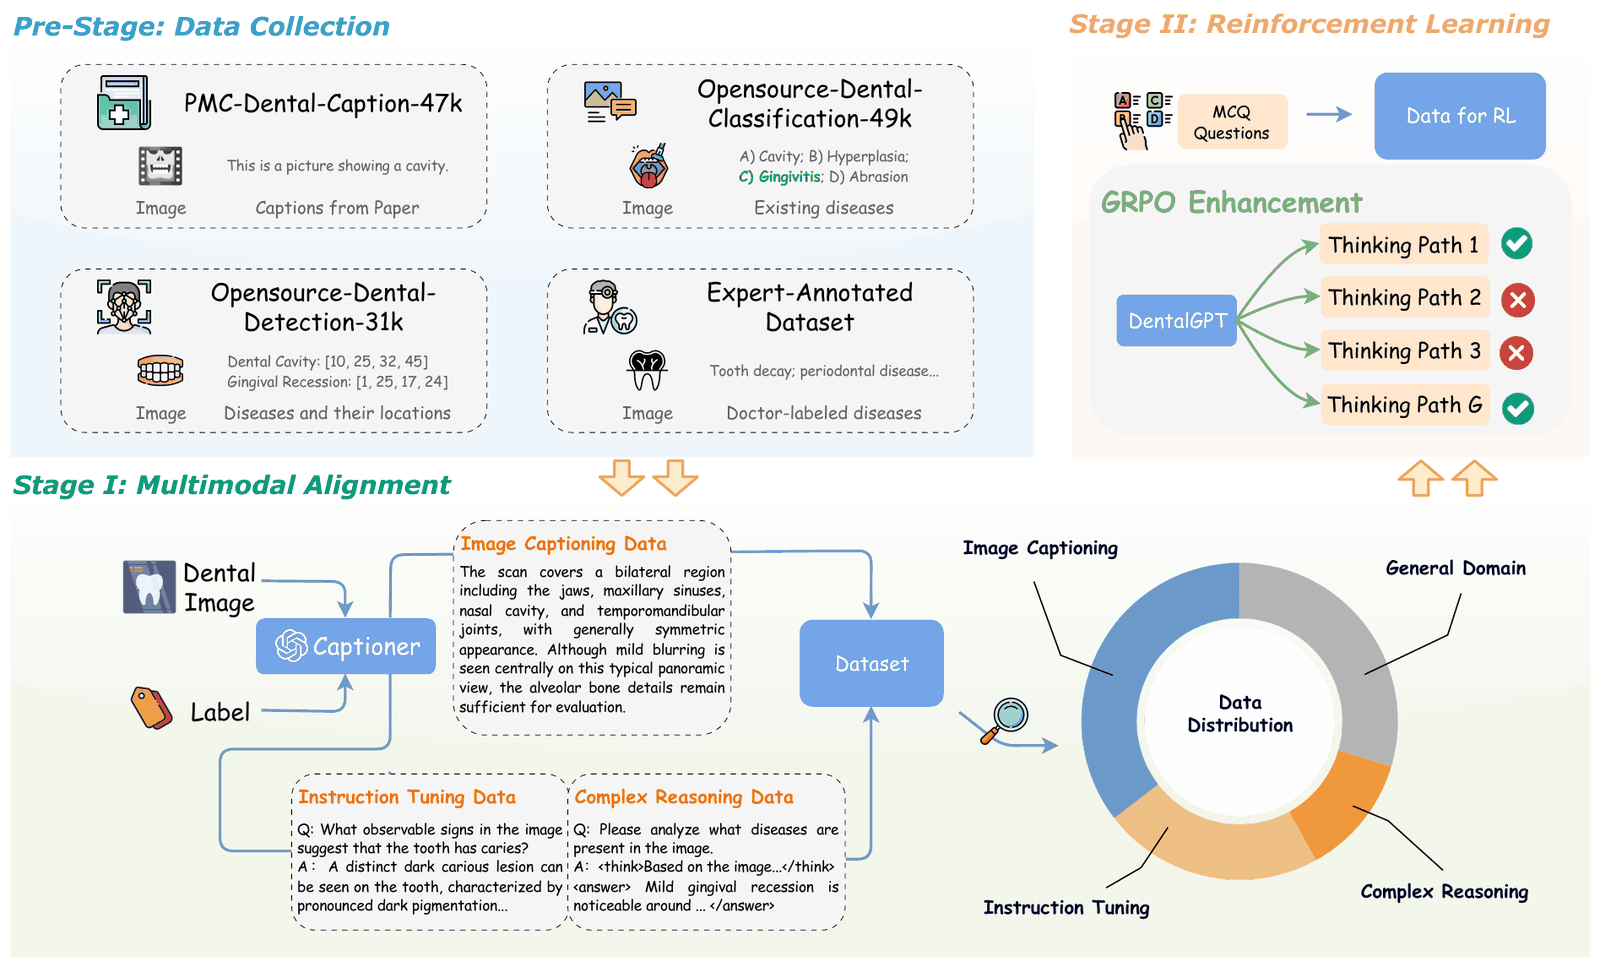
训练数据:12 万余张牙科图像
PMC-Dental-Caption-47k
从 PubMed Central 论文中筛选的牙科图像及原文图注。
Opensource-Dental-Classification-49k
整合多个开源分类数据集,图像带疾病标签。
Opensource-Dental-Detection-31k
来自病变定位数据集,带牙齿和病变的检测框。
专家标注数据
来自网络、医院影像库和公开数据集,由专业牙医标注,交叉验证一致率低于 85% 的标注被过滤掉。
两阶段训练
- 1第一阶段:多模态对齐
用 GPT-5 参考原始标签,为图像生成只描述可见特征、不做诊断假设的观察式描述,同时构造模拟诊断场景的问答和按 HuatuoGPT-o1 方法生成的复杂推理数据,并混入通用数据保持通用能力;全部数据再经 GPT-5-mini 二次核验。
- 2第二阶段:强化学习
另选第一阶段没用过的牙科图像,依据原始标签生成约 1 万道可自动判分的选择题,用 GRPO 训练:每题采样 10 个回答,奖励由答案正确性(90%)和格式规范(10%)组成,回答长度上限 8192 个 token。
效果:7B 模型,平均准确率超过 GPT-5
五项口腔基准上的准确率(%),节选自论文表 3
| 模型 | MMOral-OPG | 医学 VQA 牙科子集 | 口内照片 I | 口内照片 II | 全景片分类 | 平均 |
|---|---|---|---|---|---|---|
| Qwen2.5-VL-7B-Instruct(基座) | 27.0 | 46.1 | 48.8 | 61.8 | 50.0 | 46.7 |
| HuatuoGPT-Vision | 36.3 | 38.5 | 55.2 | 51.2 | 53.8 | 47.0 |
| MedGemma-27B-it | 50.6 | 41.8 | 52.6 | 56.2 | 61.0 | 52.4 |
| Claude-Sonnet-4.5-Thinking | 50.3 | 53.9 | 55.2 | 66.7 | 55.8 | 56.4 |
| Gemini-2.5-Pro-Thinking | 45.7 | 57.4 | 57.0 | 65.2 | 64.1 | 57.9 |
| LLaMA-4-Maverick | 51.4 | 53.9 | 61.1 | 67.1 | 59.0 | 58.5 |
| GPT-5 | 47.7 | 54.3 | 59.3 | 71.0 | 63.5 | 59.2 |
| DentalGPT(7B) | 60.0 | 54.4 | 64.1 | 72.9 | 84.0 | 67.1 |
数据来源:论文表 3;GPT-5、带 Thinking 的模型和 DentalGPT 评测时开启复杂推理模式
01
平均准确率 67.1%
比 GPT-5(59.2%)高 7.9 个百分点,比基座模型(46.7%)提升 20.4 个百分点。
02
全景片分类 84.0%
在三个由牙医交叉验证标注的分类基准上均为最高,全景片分类上基座模型和 GPT-5 分别为 50.0% 和 63.5%。
03
牙医评估
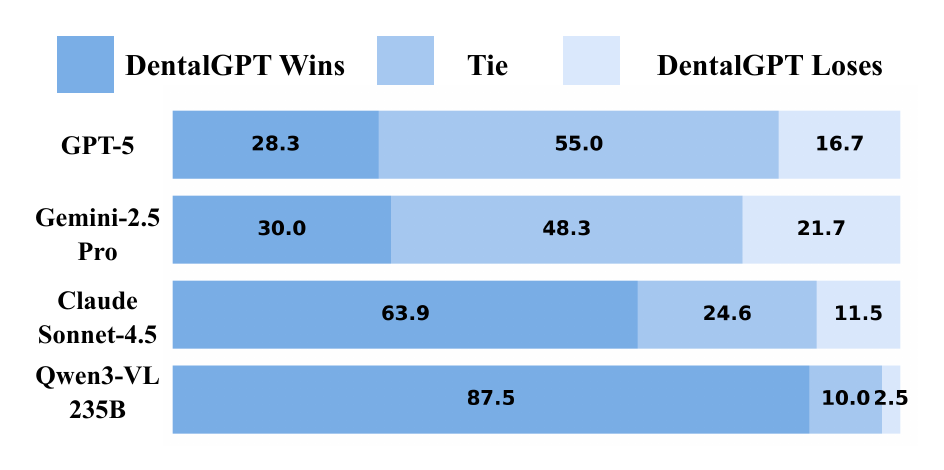
4 位执业牙医对 80 张牙科图像的回答两两比较:对比 GPT-5、Gemini-2.5-Pro,DentalGPT 胜 28.3%、30.0%,负 16.7%、21.7%;对比 Claude-Sonnet-4.5、Qwen3-VL-235B,胜率分别为 63.9%、87.5%。
04
两个阶段缺一不可
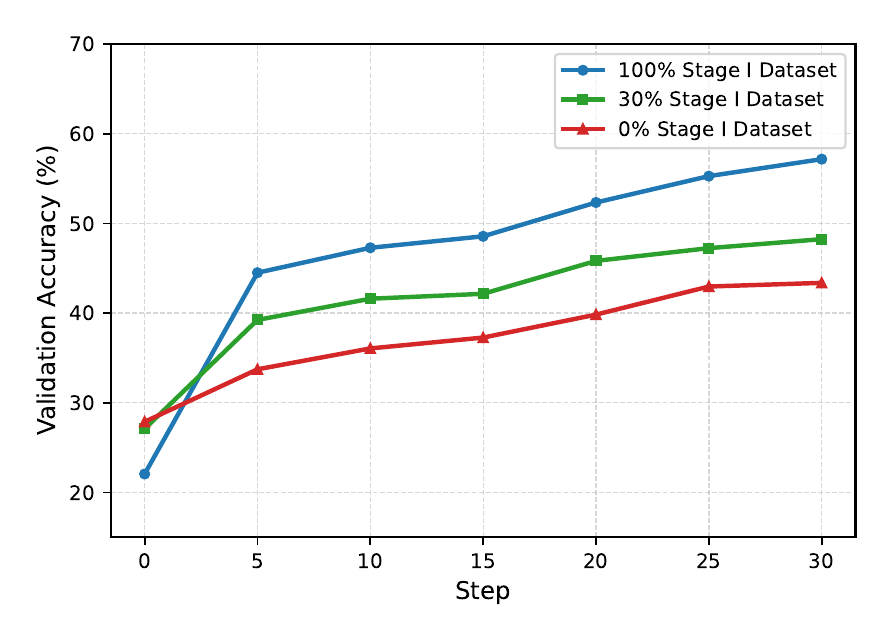
只做第一阶段对齐,平均准确率从 46.7% 升到 63.2%;再加强化学习升到 67.1%。对齐数据越多,强化学习能达到的上限越高。
DentalAgent:口腔专业任务智能体
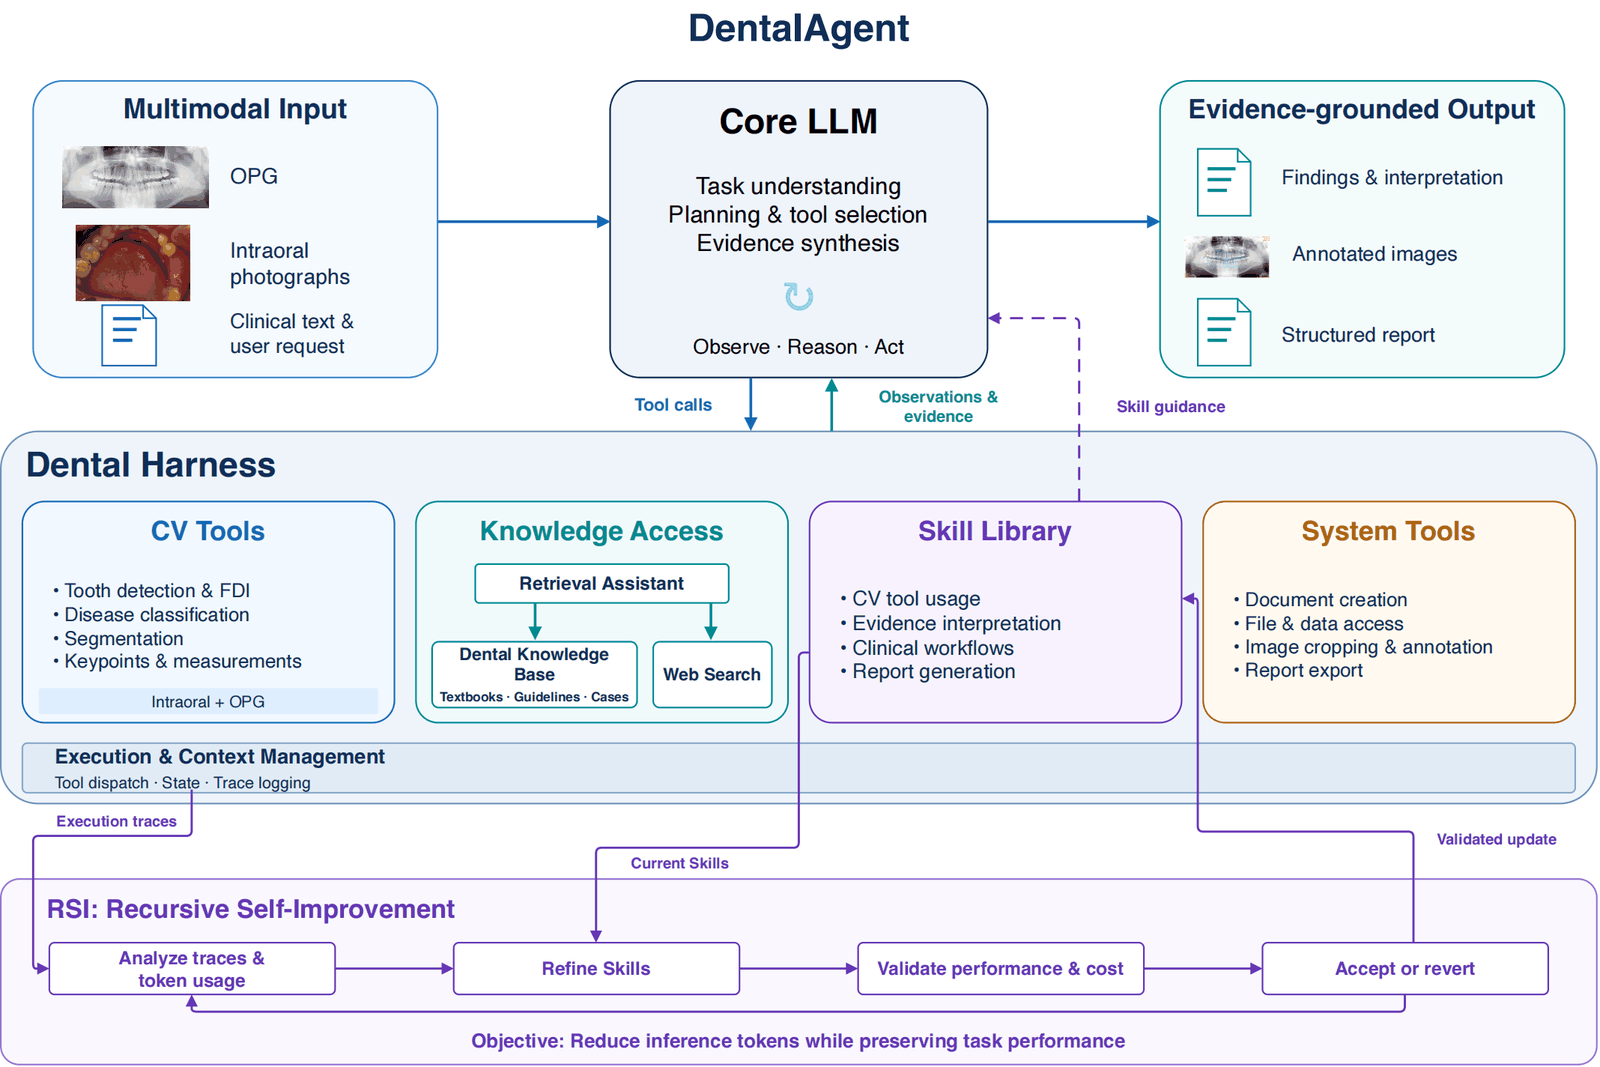
以大模型为中枢,融合多模态输入、专业工具与医学知识,形成有依据的辅助判断
01
专业工具调用
牙齿检测与 FDI 牙位编号、疾病分类、分割、关键点与测量等视觉工具,处理口内照片与全景片;大模型负责规划调用顺序并整合结果。
02
医学证据支持
检索由教材、指南和病例组成的口腔知识库,把工具观察与检索到的知识一起作为证据,输出检查发现、标注图像和结构化报告。
03
持续反馈优化
递归自我改进回路分析执行轨迹与 token 用量,改进技能并验证性能与成本,在保持任务表现的同时降低推理开销。
定位为辅助判断:输出带证据的检查发现与报告,供医生核验参考;目前正在口腔文本与影像任务上开展初步评测。
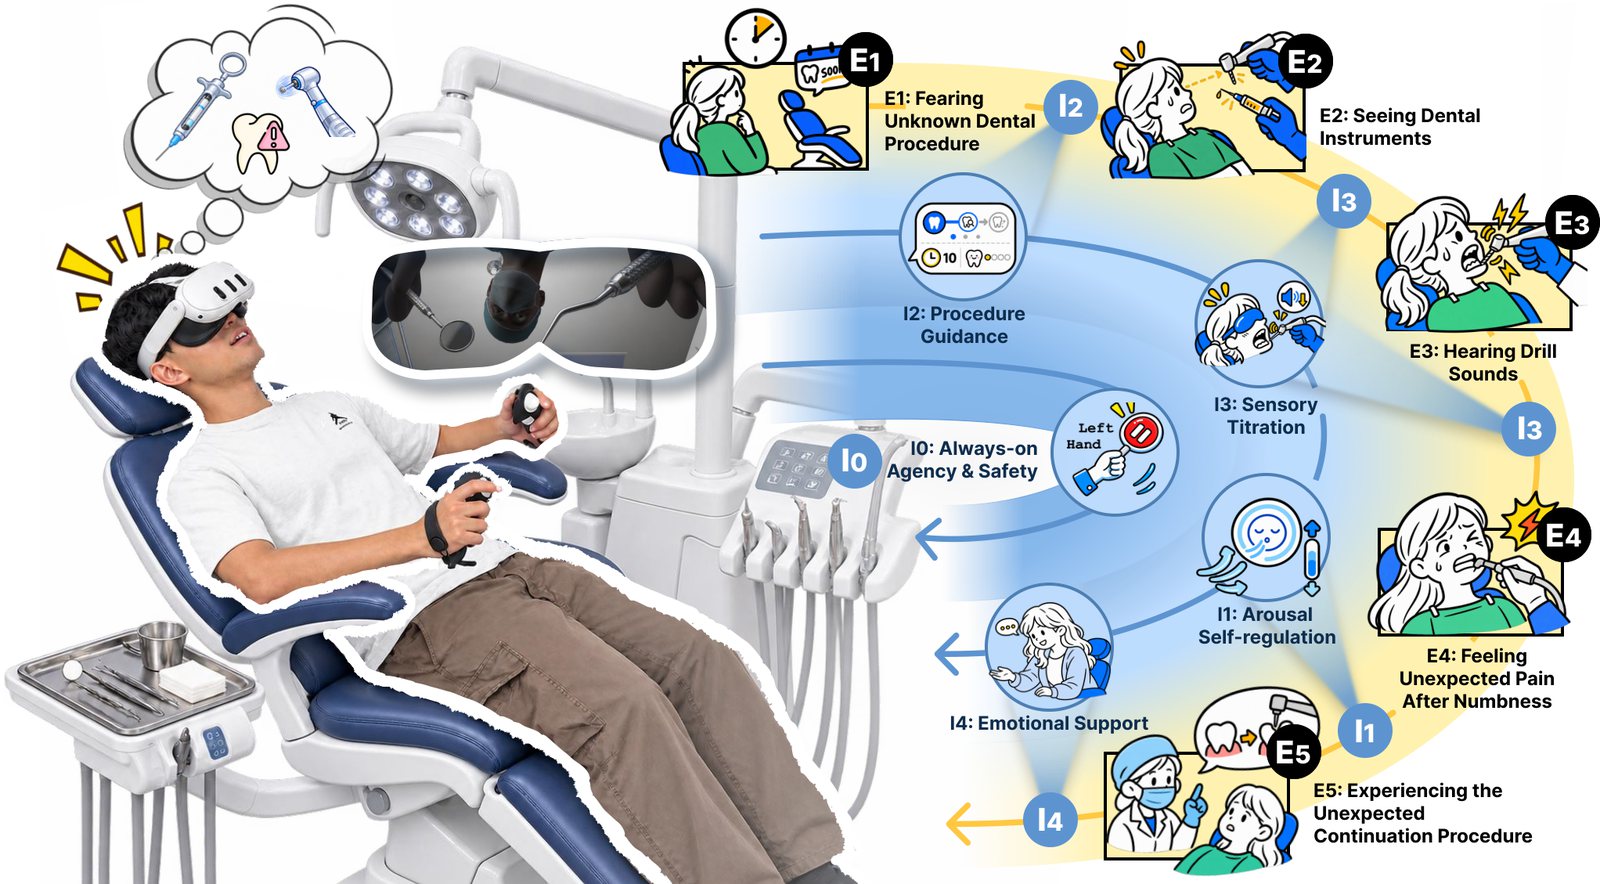
阅读 DentalAgent 技术解读 →VR/AR 与 3D 可视化:让口腔诊疗看得懂、少紧张
大模型之外,我们用沉浸式和三维可视化技术改善患者的就诊体验和口腔健康教育。
3D 可视化 · 医学教育
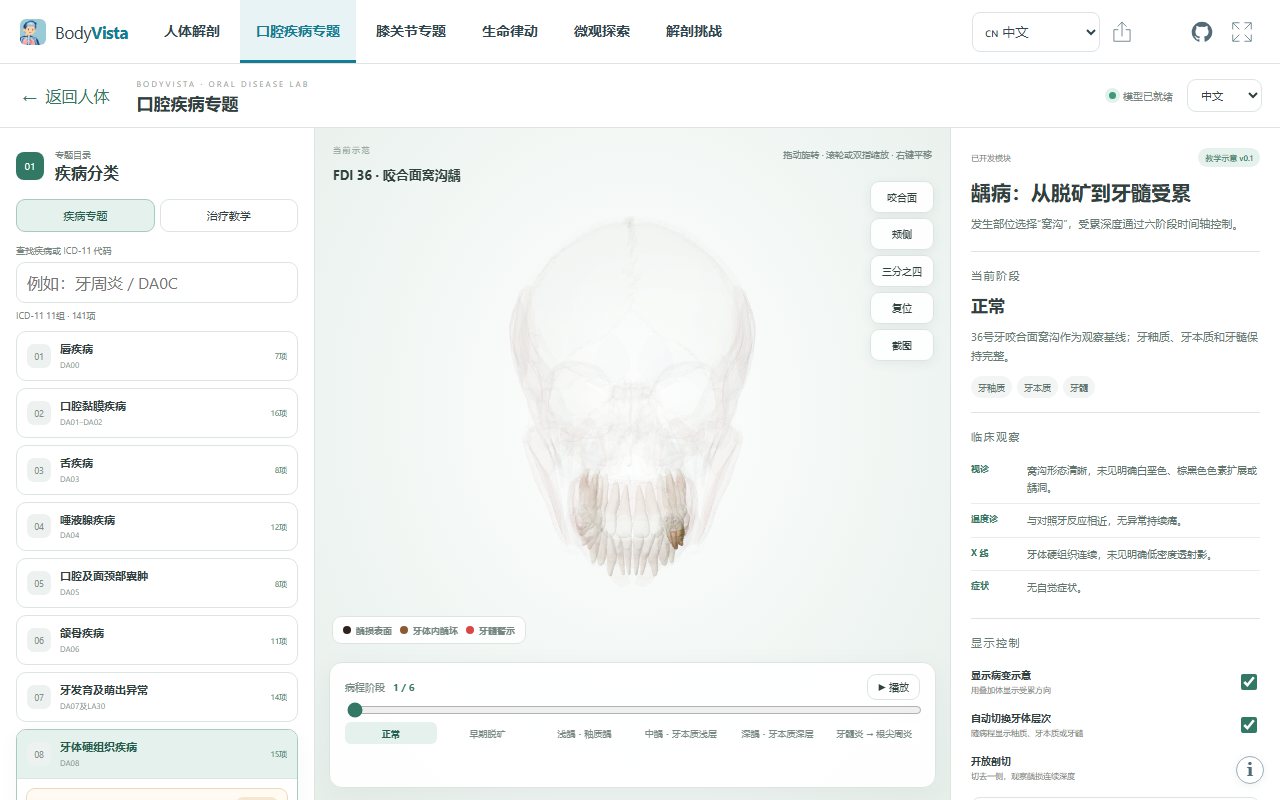
DentalVista 口腔与人体 3D 解剖
基于开源项目 BodyVista,在浏览器里探索三维人体结构和口腔疾病专题:口腔疾病按 ICD-11 分为 11 组、141 项,龋病等专题用分阶段动画演示病程;支持剖切、测量、标注和解剖挑战,触屏可单指旋转、双指缩放。
多模态数据与专病数据体系
构建覆盖影像、文本、长期随访与专病知识的口腔多模态数据底座
9,000 万+条医疗训练与评测数据
6,051 万对医学图文数据 PubMedVision-Plus
2,600 万条中文医疗问答 Huatuo-26M
12 万+ 张标注牙科影像 DentalGPT
数据积累
团队累计构建 9,000 万+ 条医疗训练与评测数据,覆盖文本、影像、视频与多语言,包括医疗领域预训练与微调数据以及专家标注数据。
| 数据类型 | 数据来源 | 数据量 |
|---|---|---|
医学图文预训练数据集 | PubMedVision-Plus | 60,513,727 对 含约 1,200 万对高质量核心数据 |
多模态医疗大模型对齐与对话数据集 | PubMedVision | 1,294,062 条 |
多模态医疗对话数据集 | Med-MAT | 2,360,000 条 |
多模态医疗视频生成数据集 | MedVideoCap-55K | 55,000 条 |
纯文本多语言医疗数据集 | ApolloMoEDataset | 292,914 条 |
纯文本大规模医疗数据集 | Huatuo-26M | 26,000,000 条 |
纯文本复杂推理数据集 | medical-o1-reasoning-SFT | 50,000 条 |
牙科专病多模态训练集 | DentalGPT | 240,000 条 含120,000张牙科影像 |
标注平台
提供覆盖医学影像数据管理、多人协同标注、审核质检、AI 预标注的一体化数据生产平台。


牙科评测:GlobalDentBench 与 OmniDentBench
用跨国、专家级的评测发现模型的推理弱点,指引 DentalGPT 持续改进
"这个 AI 模型在真实临床环境中是否安全、有效、可用?"
DentalGPT的全球验证与多中心协同
全球首个合作口腔大模型验证,构建覆盖多机构、多地区、多人群的口腔AI验证网络
全球合作协议签署

多中心协同体系
临床专家协同
口腔专科专家参与模型验证与能力评估。
多机构数据协同
形成跨机构、多中心数据验证体系。
Benchmark协同建设
共同构建口腔AI标准化评测体系。
联合科研合作
支撑联合课题、多中心研究与成果转化。
技术积累:从 HuatuoGPT-o1 到 DentalGPT
DentalGPT 承接团队在医疗大模型上的长期积累:复杂推理数据沿用 HuatuoGPT-o1 的方法构建,多模态能力也从“看懂”延伸到“生成”
医疗复杂推理
HuatuoGPT-o1:慢推理、长思考的医疗大模型
医学推理不像数学题那样容易验证。HuatuoGPT-o1 提出“可验证的医学问题”和医学验证器:先在验证器引导下搜索复杂推理路径来微调模型,再用基于验证器奖励的强化学习进一步提升推理能力,只用 4 万道可验证问题就超过了通用和医学专用的基线模型,受到业界广泛关注。
DentalGPT 第一阶段的复杂推理数据沿用了这一方法,第二阶段同样用可自动判分的题目做强化学习。自由动脉 CTO 蔡镇阳、首席 AI 科学家王本友都是论文作者。


- Junying Chen, Zhenyang Cai, Ke Ji, Xidong Wang, Wanlong Liu, Rongsheng Wang, Jianye Hou, Benyou Wang. HuatuoGPT-o1, Towards Medical Complex Reasoning with LLMs. arXiv:2412.18925
- Junying Chen, Chi Gui, Anningzhe Gao, Ke Ji, Xidong Wang, Xiang Wan, Benyou Wang. CoD, Towards an Interpretable Medical Agent using Chain of Diagnosis. arXiv:2407.13301
医学视频生成
MedGen:医学视频生成模型
医学视频对临床培训、教学和模拟都很重要,但通用视频生成模型面对医学提示时,常常生成不真实或错误的内容。香港中文大学(深圳)FreedomAI 团队与自由动脉发布了 MedVideoCap-55K(5.5 万余段真实医疗场景视频片段,论文称其为首个大规模、多样、描述丰富的医学视频生成数据集),并在此基础上训练出 MedGen:在多个基准上,它的视觉质量和医学准确性在开源模型中领先,可与商业系统相当。
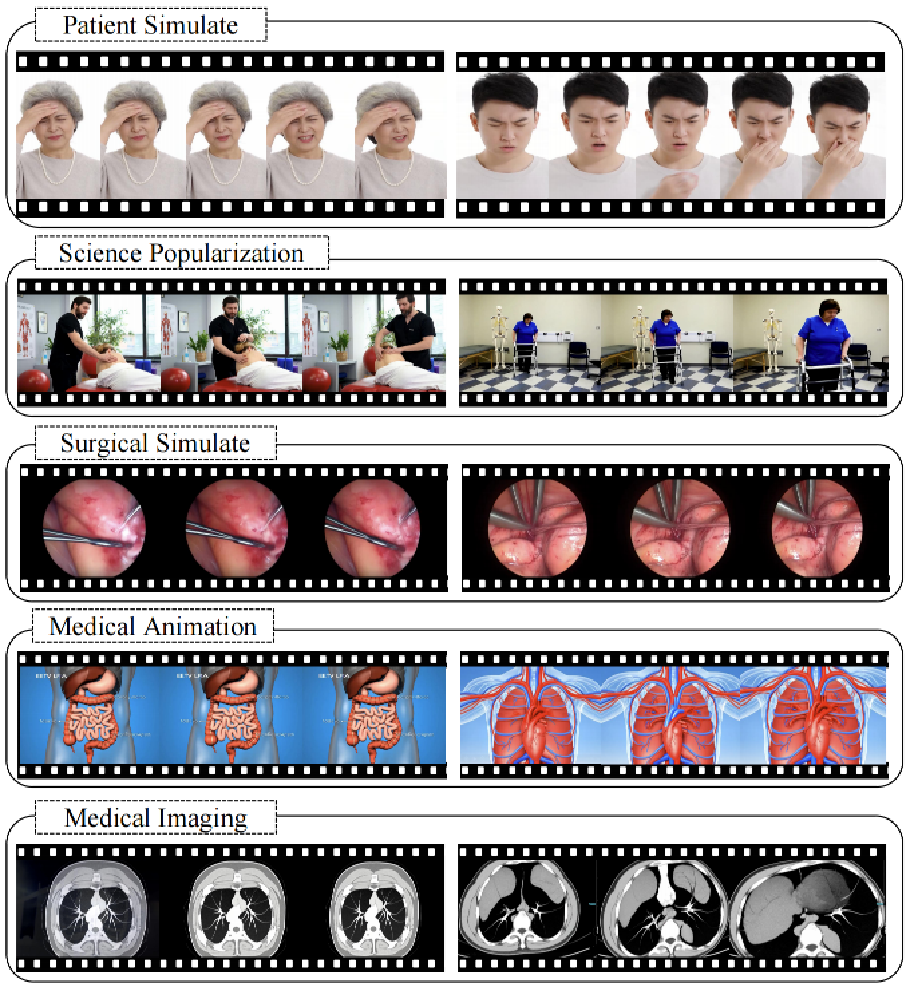
MedGen 的多场景应用探索
MedGen 在保证医学内容准确性的同时生成高质量视频,可用于手术模拟、医学教育、科普动画与远程会诊等场景。
下游任务数据增强
手术流程识别、病变检测、诊断辅助等医疗视频任务普遍面临标注数据稀缺、样本不均衡和隐私保护等问题。我们把 MedGen 生成的视频与原始训练数据结合,在多种医学视频分类任务中验证了它作为数据增强工具的效果。
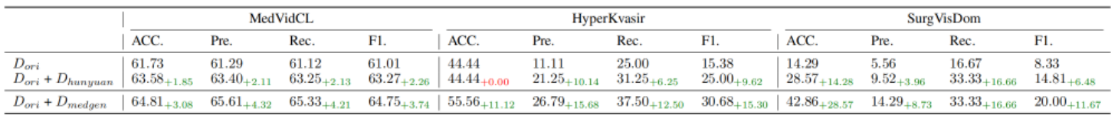
MedGen 和 HunyuanVideo 在三个医学视频监督下游任务中作为数据增强的效果对比
团队与合作机构
 蔡镇阳自由动脉 CTO共同第一作者
 赵俊杰自由动脉 COO共同第一作者
 李健铨自由动脉 CEO作者
 冯相义自由动脉 医疗产品副总裁作者
 王俊文自由动脉 首席医学科学家通讯作者
 王本友自由动脉 首席 AI 科学家通讯作者
论文署名单位
南方医科大学深圳口腔医院(坪山)香港中文大学(深圳)北京大学自由动脉香港大学牙医学院北京协同创新研究院国家健康医疗大数据研究院(深圳)深圳河套学院深圳市大数据研究院