技术解读|DentalAgent:让口腔大模型调用专业工具,给出有据可查的辅助判断
口腔诊疗中的一次判断,往往要同时看全景片和口内照片,结合病史与患者诉求,还要说清依据从哪里来。只让大模型“看图作答”,结论难以追溯,也难以嵌入专业的工作流程。
为此,自由动脉团队构建了 DentalAgent,一个面向口腔专业任务的智能体(Agent)框架。它以大模型为中枢,融合多模态输入、专业工具与医学知识,目标是形成有依据的辅助判断,让模型能力真正落到具体的口腔专业任务上。
框架:一个“大脑”,一套口腔工具箱
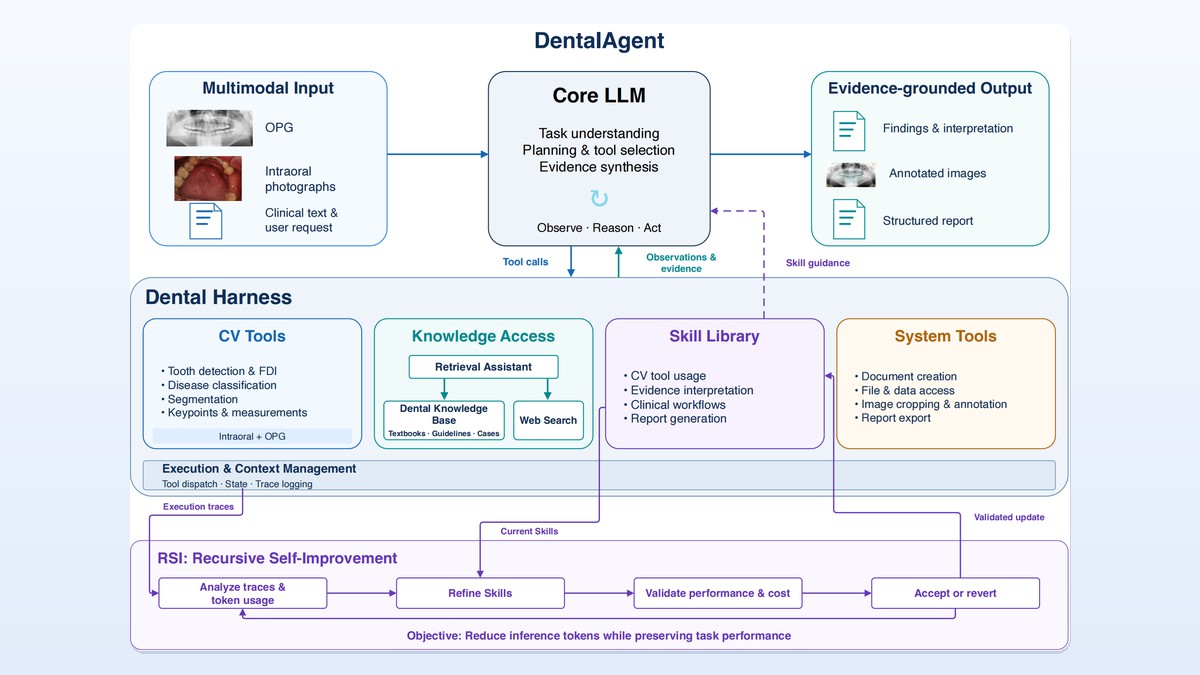
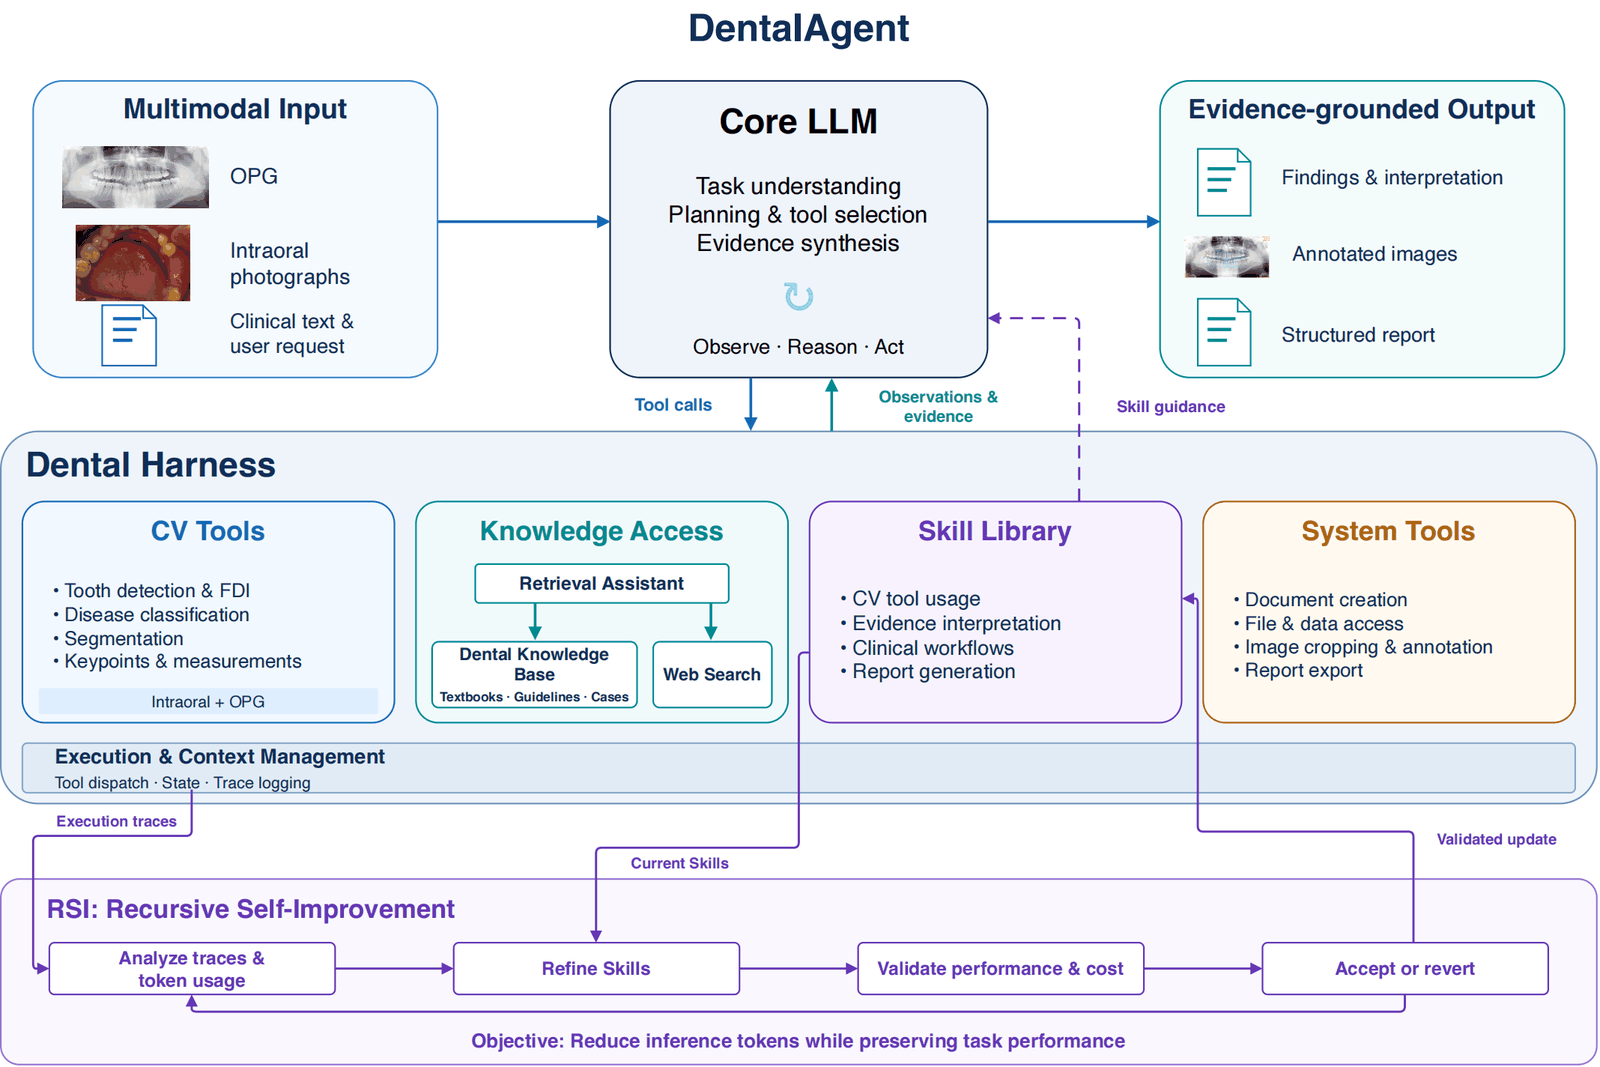 图 1:DentalAgent 框架示意。图源:自由动脉
DentalAgent 由四部分组成(图 1):
- 多模态输入:全景片(OPG)、口内照片,以及临床文本和用户请求。
- 核心大模型(Core LLM):负责理解任务、规划并选择工具、综合证据,按“观察—推理—行动”的循环逐步推进。
- 口腔任务执行层(Dental Harness):大模型通过工具调用使用这一层的能力,并取回观察结果和证据。
- 有据可查的输出:包括检查发现与解读、标注后的图像和结构化报告。
其中,口腔任务执行层集成了四类能力:
- 视觉工具:牙齿检测与 FDI 牙位编号、疾病分类、分割、关键点与测量,可处理口内照片和全景片;
- 知识访问:由检索助手连接收录教材、指南和病例的口腔知识库,并可进行网络搜索;
- 技能库:沉淀视觉工具使用、证据解读、临床工作流和报告生成等技能,为大模型提供操作指引;
- 系统工具:支持文档创建、文件与数据访问、图像裁剪与标注、报告导出。
底层的执行与上下文管理模块负责工具调度、状态维护和执行轨迹记录。
三个关键设计
专业工具调用。 牙位识别、病变分类、测量这类需要精确视觉处理的环节,交给专门的视觉工具完成;大模型负责规划调用顺序,并整合各个工具返回的结果。
医学证据支持。 大模型可以检索口腔知识库和网络信息,把工具的观察结果与检索到的知识一起作为证据,汇总成检查发现、标注图像和结构化报告,让输出建立在证据之上。
持续反馈优化。 框架设计了递归自我改进(RSI,Recursive Self-Improvement)回路:分析执行轨迹和 token 用量,据此改进技能,再验证性能与成本,最后决定接受还是回退这次修改;验证通过的更新写回技能库。这一回路的目标,是在保持任务表现的同时减少推理所需的 token。
从模型能力到专业任务执行
如果说 DentalGPT 这样的口腔多模态大模型解决的是“看懂、想对”,DentalAgent 关注的则是下一步:如何把模型能力组织成可执行、可追溯的专业任务流程。
DentalAgent 的设计目标,是以专业工具、知识与证据增强大模型,提升口腔专业任务的表现。目前,团队正在口腔文本任务以及口内照片、全景片等影像任务上对框架开展初步评测。
需要强调的是,DentalAgent 的定位是辅助判断:它输出带证据的检查发现、标注图像和报告,供医生核验参考,而不是替代医生作出诊疗决定。