研究脉络|港中深 HuatuoGPT 系列五代演进:从医疗对话到纯强化学习适配,27B 模型 HealthBench 总分 70.1
让通用大模型成为可靠的医疗助手,要过好几道关:说话要像医生,要掌握扎实的医学知识,要看得懂医学影像,还要能在复杂问题上一步步推理。
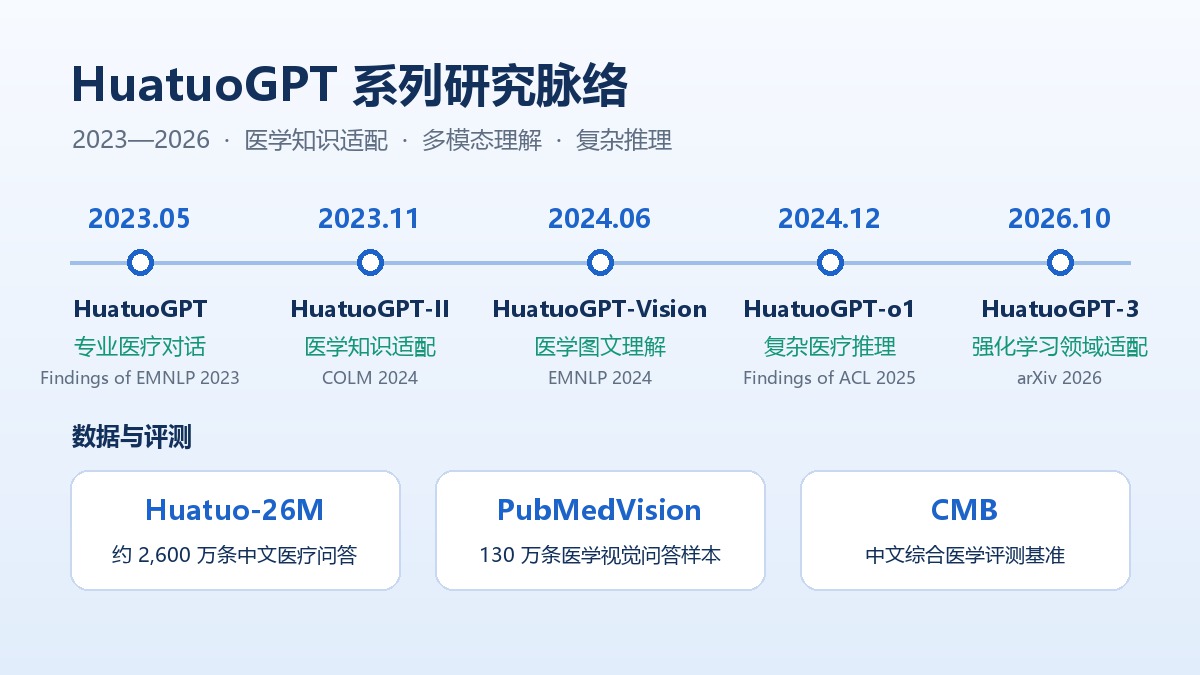
自 2023 年起,香港中文大学(深圳)的研究团队与合作者围绕 HuatuoGPT 系列持续开展医疗大模型研究:从专业医疗对话、医学知识适配、医学图文理解,一路走到复杂医疗推理和纯强化学习的领域适配,并沉淀了 Huatuo-26M、PubMedVision 等数据集和 CMB 评测基准。自由动脉多位核心团队成员参与了其中多项工作。这条研究线,也为自由动脉的口腔多模态大模型 DentalGPT 提供了数据建设、模型训练和专业评测的方法基础。
| 首次公开 | 工作 | 关注问题 | 发表情况 |
|---|---|---|---|
| 2023 年 5 月 | HuatuoGPT | 专业医疗对话 | Findings of EMNLP 2023 |
| 2023 年 11 月 | HuatuoGPT-II | 医学知识适配 | COLM 2024 |
| 2024 年 6 月 | HuatuoGPT-Vision | 医学图文理解 | EMNLP 2024 |
| 2024 年 12 月 | HuatuoGPT-o1 | 复杂医疗推理 | Findings of ACL 2025 |
| 2026 年 10 月 | HuatuoGPT-3 | 强化学习领域适配 | arXiv 预印本(2026) |
表:HuatuoGPT 系列时间线。时间为论文首次公开的时间,发表情况为论文发表的会议或预印本平台。
2023:从会回答问题到像医生一样沟通
HuatuoGPT:真实医生数据与蒸馏数据结合
HuatuoGPT 是面向医疗咨询的大模型。它的核心做法是在监督微调阶段同时使用两类数据:一类是从 ChatGPT 蒸馏的数据,回答详尽、表达规范;另一类是来自医生的真实数据,更接近医生综合问诊、诊断的方式。团队再训练一个奖励模型,以 RLAIF(Reinforcement Learning from AI Feedback,基于 AI 反馈的强化学习)的方式,把两类数据的长处对齐到模型上。
论文报告,HuatuoGPT 在 GPT-4 评测、人工评测和医学基准上取得了当时开源模型中最好的医疗咨询表现,并且在多数情况下超过了它的“老师”ChatGPT。论文发表于 Findings of EMNLP 2023。
HuatuoGPT-II:一个阶段完成医学适配
把通用模型变成医学专家,常规做法是“继续预训练 + 监督微调”两步走,但两个阶段的数据在语言、体裁和格式上差异很大。HuatuoGPT-II 把两个阶段的异构数据统一转成简单的“输入—输出”对,用一个阶段完成医学领域适配。
团队在中医等 ChatGPT 表现相对较弱的领域验证了这一做法:HuatuoGPT-II 在医师资格考试等多项中文医学基准上取得领先表现,在一次全新的国家医师资格考试测试中取得最佳成绩。论文发表于 COLM 2024。
数据与评测:Huatuo-26M 和 CMB
同一时期,团队公开了 Huatuo-26M,这是一个包含约 2,600 万条问答对的中文医疗问答数据集,可用于检索与生成任务评测、检索增强生成的外部知识,以及模型的继续训练(论文后来发表于 Findings of NAACL 2025)。
评测方面,团队提出了中文综合医学评测基准 CMB(Comprehensive Medical Benchmark in Chinese)。作者认为,直接翻译英文医学评测会与本土医疗环境“水土不服”,因此 CMB 完全立足于中文语言和文化环境设计,中医是其中的重要组成部分,但并非全部。论文发表于 NAACL 2024。
2024:看懂影像,学会推理
HuatuoGPT-Vision:130 万条样本注入医学视觉知识
受隐私和标注成本限制,高质量的医学图文数据一直稀缺。团队从 PubMed 精炼医学图文对,并让能看到图像的 GPT-4V 对数据去噪、重新组织,构建了含 130 万条医学视觉问答样本的 PubMedVision。
实验表明,PubMedVision 能显著提升现有多模态大模型的医学能力,包括在 MMMU 健康与医学赛道上的表现;医学专家的人工检查也验证了数据质量。基于这一数据训练的 34B 医学多模态模型 HuatuoGPT-Vision,在医学多模态场景中的表现领先于其他开源模型。论文发表于 EMNLP 2024。
HuatuoGPT-o1:用可验证问题训练复杂推理
数学题可以对答案,医学推理却很难验证。HuatuoGPT-o1 把有挑战性的医学考试选择题改写成开放式、答案唯一且可客观核对的“可验证医学问题”,并引入医学验证器(Verifier)检查模型输出是否正确。
训练分两步(图 1):先由验证器引导,搜索出正确的复杂推理轨迹,用来微调模型;再以验证器给出的奖励做强化学习(PPO),进一步提升复杂推理能力。论文显示,只用 4 万道可验证医学问题,HuatuoGPT-o1 就超过了通用和医学专用的开源基线模型;复杂推理能提升医疗问题的求解能力,并且能从强化学习中获益更多。论文以 Towards Medical Complex Reasoning with LLMs through Medical Verifiable Problems 为题发表于 Findings of ACL 2025。
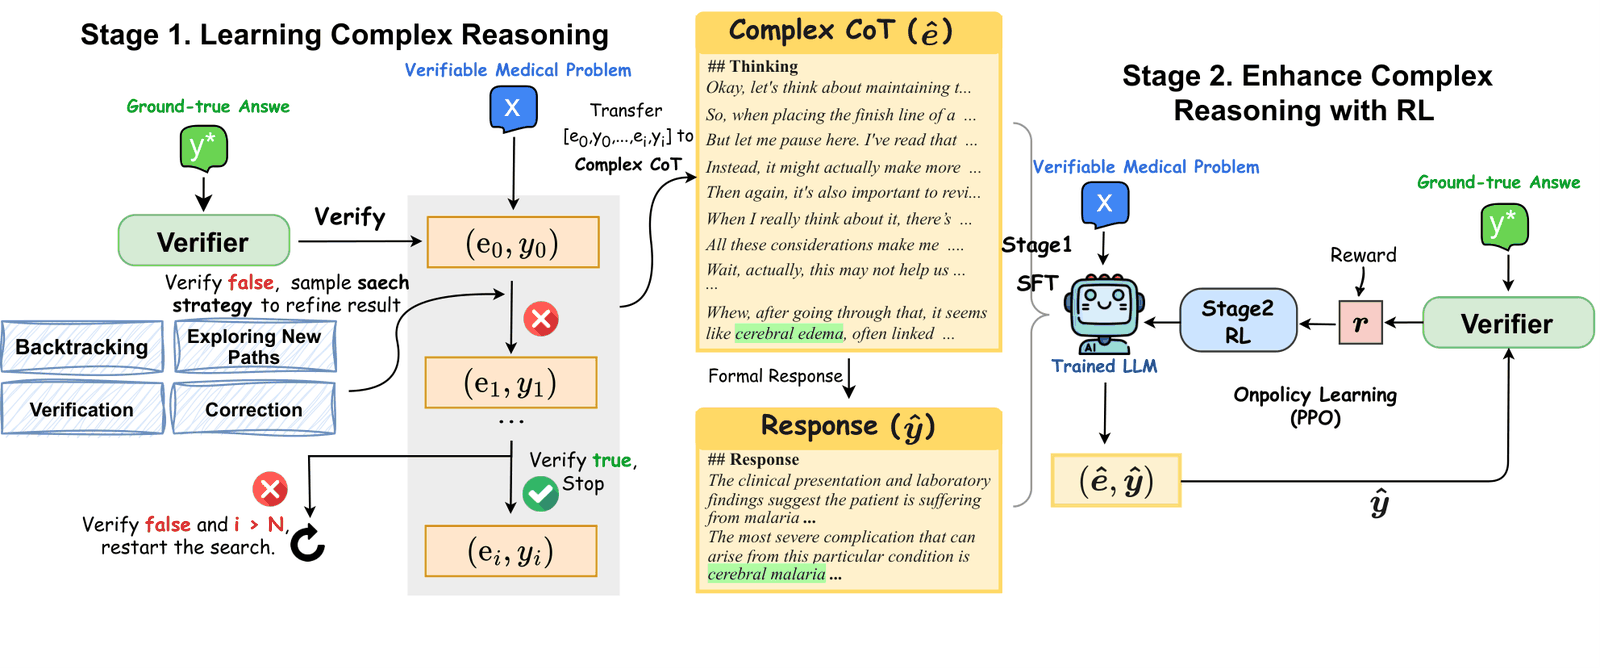 图 1:HuatuoGPT-o1 的两阶段训练。左:在验证器引导下搜索复杂推理轨迹并用于微调;右:用验证器奖励进行强化学习。图源:论文
2026:HuatuoGPT-3,不做监督微调,直接用强化学习适配
“先监督微调(SFT)、再强化学习(RL)”是目前主流的领域适配流程,冷启动方便,但可能降低模型的探索多样性,多阶段优化也带来额外的复杂度。纯在线策略(on-policy)强化学习则面临冷启动难题。把教师模型的输出混入训练的混合策略强化学习也有两个问题:训练早期,教师输出中有价值的 token 学得太慢,作者称之为“梯度饥饿”(Gradient Starvation);训练后期,过时的教师输出反而把模型往回拉,称为“教师分布锚定”(Teacher-Distribution Anchoring)。
为此,团队提出 OnePO(One-stage Policy Optimization,单阶段策略优化),把教师输出当作“临时向导”(图 2):
- 自适应目标演化(Adaptive Objective Evolution):对当前模型概率很低、但有信息量的教师 token 加强学习信号,缓解梯度饥饿;
- 教师退役(Teacher Retirement):只有当教师输出的奖励严格高于当前模型同组输出的最高奖励时,才保留它参与训练;模型一旦追上,教师输出自动“退役”,训练回到标准的在线策略强化学习。
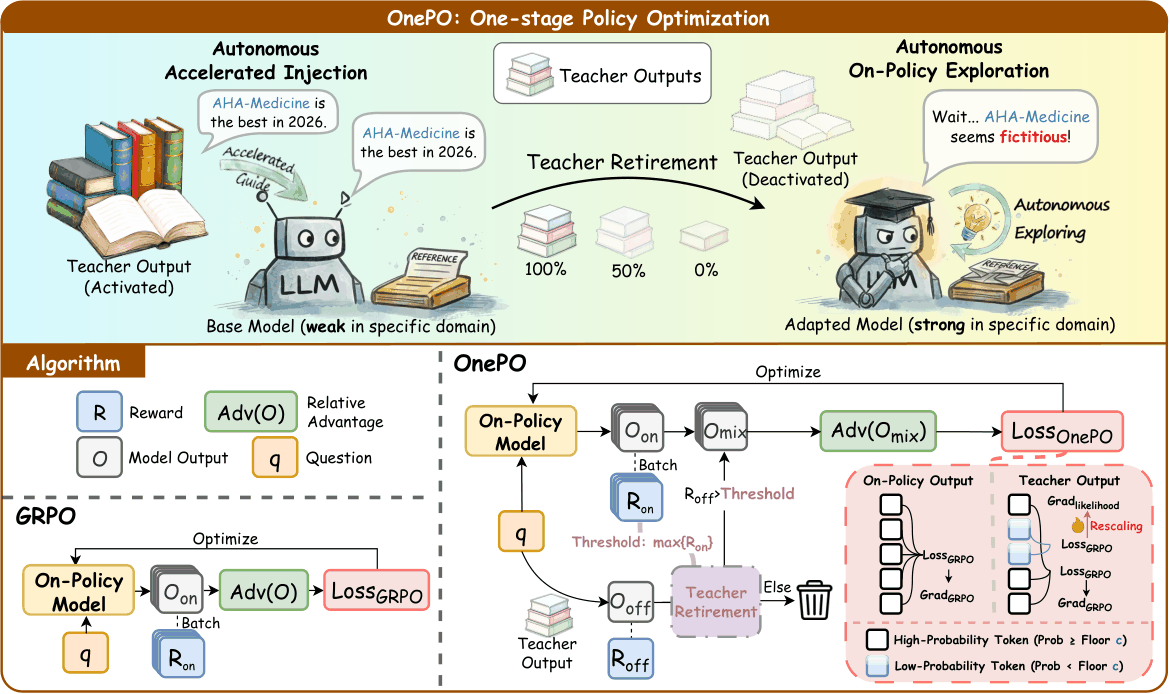 图 2:OnePO 方法概览。训练早期由教师输出加速领域知识学习,随后逐步回到模型自主探索。图源:论文
在医学领域,OnePO 只用 2 万条训练样本,就在 HealthBench(Total)上达到 67.2 分,比 SFT+RL 和纯 RL 分别高 2.7 分和 7.4 分。扩大训练数据后,团队训练出开源医疗大模型 HuatuoGPT-3 系列,包括基于 Qwen3.5-9B 和 Qwen3.8-27B 的 9B、27B 两个版本。其中 27B 版本在 HealthBench(Total)上得分 70.1,在 HealthBench Professional 上得分 71.4,高于论文对比的 GPT-6 Astra(high)的 57.8 分和 62.5 分(图 3)。
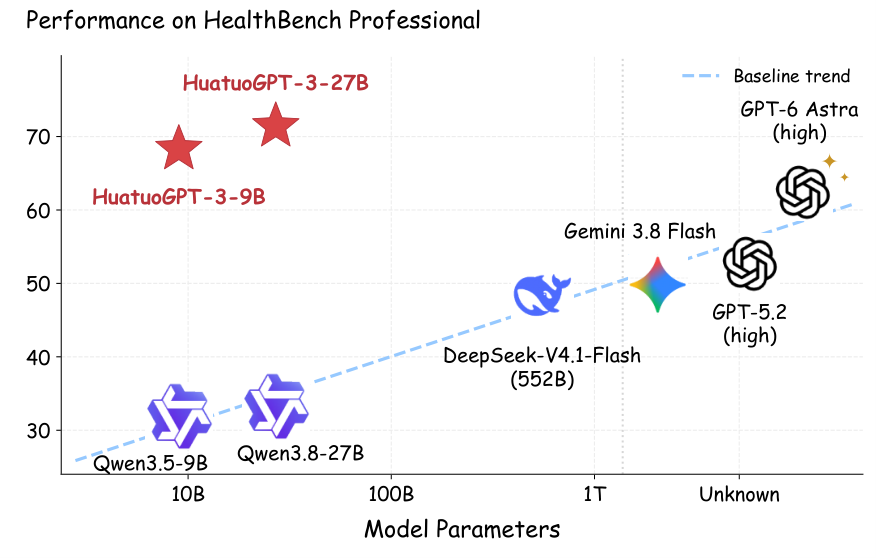 图 3:HealthBench Professional 得分与模型参数规模。图源:论文
HuatuoGPT-3 技术报告于 2026 年 10 月在 arXiv 公开,是 ICML 2026 论文 OnePO 的扩展版本,模型与代码已开源。
从 HuatuoGPT 到 DentalGPT
口腔是一个高度依赖影像、知识又非常专门的领域,HuatuoGPT 系列积累的方法在这里得到了延续:
- 推理数据的构造方法:DentalGPT 构建复杂推理(思维链)数据时,直接沿用了 HuatuoGPT-o1 的方法。
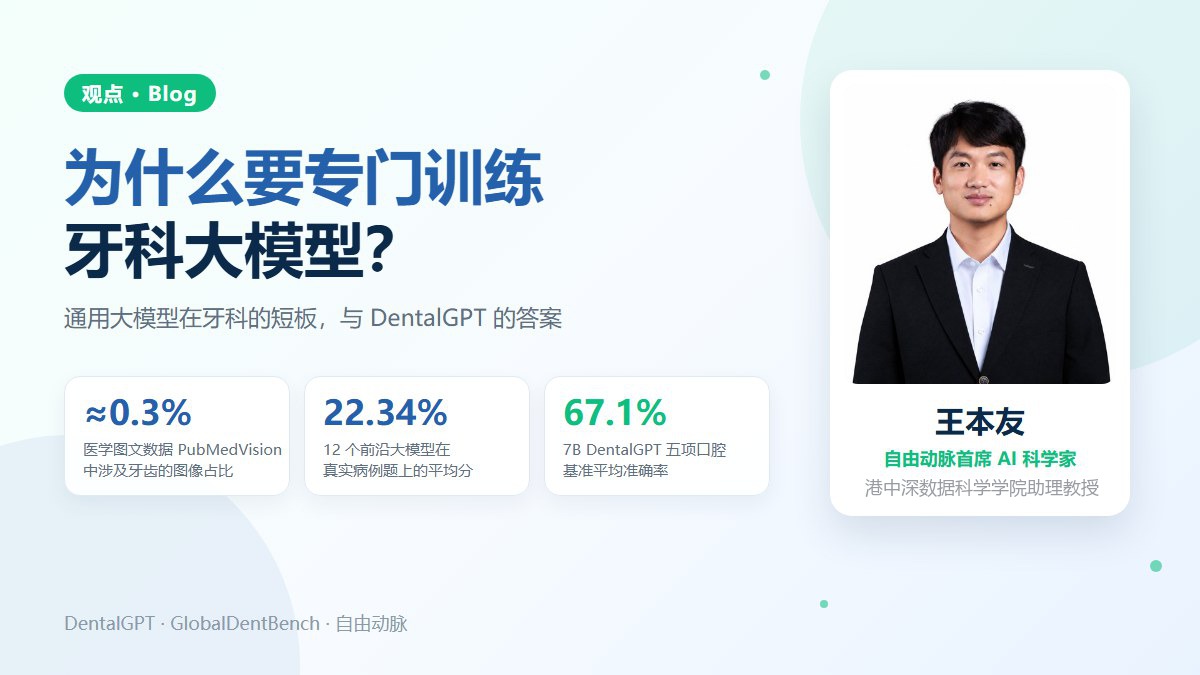
- 从通用医学数据到专科数据:DentalGPT 预印本统计,PubMedVision 中涉及牙齿的图像只占约 0.3%,团队因此专门构建了 12 万余张牙科图像的数据集。
- 专科评测:在 DentalGPT 的对比实验中,医学多模态模型 HuatuoGPT-Vision 在五项口腔基准上的平均准确率为 47.0%,经过口腔数据训练和强化学习的 7B 模型 DentalGPT 为 67.1%。DentalGPT 论文认为,领域专属的数据和训练策略对口腔 AI 至关重要。
- 强化学习:从 HuatuoGPT-o1 的 PPO,到 DentalGPT 的 GRPO,再到 HuatuoGPT-3 的 OnePO,强化学习贯穿了这条研究线的后半程。
团队与影响
以上成果来自香港中文大学(深圳)的研究团队及合作者,自由动脉核心团队成员参与了其中多项工作。自由动脉首席 AI 科学家王本友是上述论文的作者之一;自由动脉 CTO 蔡镇阳是 HuatuoGPT-o1 的第二作者,也是 HuatuoGPT-Vision 的作者之一。系列中 HuatuoGPT-II、HuatuoGPT-Vision、HuatuoGPT-o1 和 HuatuoGPT-3 的第一作者均为 Junying Chen。
论文与资源
- HuatuoGPT(Findings of EMNLP 2023):https://aclanthology.org/2023.findings-emnlp.725/
- HuatuoGPT-II(COLM 2024):https://openreview.net/forum?id=eJ3cHNu7ss
- HuatuoGPT-Vision(EMNLP 2024):https://aclanthology.org/2024.emnlp-main.418/
- HuatuoGPT-o1(Findings of ACL 2025):https://aclanthology.org/2025.findings-acl.751/
- HuatuoGPT-3(arXiv 2026):https://arxiv.org/abs/2610.05966
- Huatuo-26M(Findings of NAACL 2025):https://aclanthology.org/2025.findings-naacl.211/
- CMB(NAACL 2024):https://aclanthology.org/2024.naacl-long.343/
- 代码与模型:https://github.com/FreedomIntelligence